

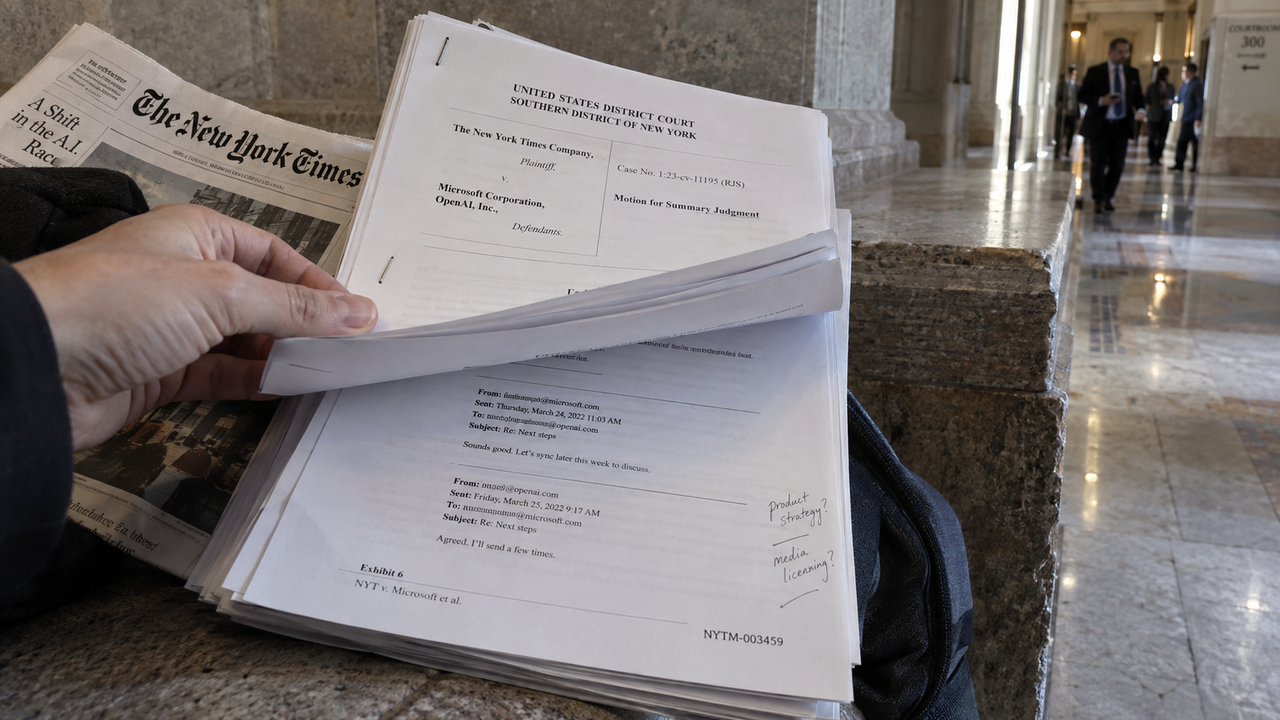
Dentro Microsoft c’era chi descriveva la raccolta di notizie per addestrare l’intelligenza artificiale come un furto di lavoro di proporzioni storiche. È quanto emerge dai documenti interni citati dagli editori guidati dal New York Times in una richiesta di giudizio sommario resa pubblica nella causa contro il gruppo e OpenAI. Gli atti includono dati Microsoft che registrano, per alcune delle testate ricorrenti, cali dei tassi di clic compresi tra l’83% e il 93%; per altre, tra il 51% e il 94%.
Le parole più nette sono attribuite a Brent Hecht, direttore di Applied Science di Microsoft. Nei documenti richiamati dagli editori, il dirigente definiva lo scraping delle notizie per l’addestramento un furto sbalorditivo e senza precedenti, forse il più grande furto di lavoro nella storia umana. Contestava anche la compatibilità della raccolta su vasta scala con il fair use, la dottrina invocata dalle aziende per difendere l’utilizzo dei contenuti. Hecht riconosceva inoltre che quasi nessun autore aveva previsto un impiego simile delle proprie opere, senza ricevere compensi.
Anche in OpenAI il rischio per gli editori era stato discusso esplicitamente. Nick Turley, responsabile di ChatGPT, scriveva in un messaggio interno che prodotti commerciali addestrati sulle notizie avrebbero rappresentato una minaccia esistenziale se utilizzati al posto dei fornitori di informazione. Un documento Microsoft descriveva un circolo vizioso capace di danneggiare contemporaneamente le prestazioni dei modelli e l’intero web: il prodotto finale minacciava le fondamenta economiche dei fornitori essenziali della propria filiera di contenuti.
La sostituzione delle testate passa dal comportamento degli utenti. Nella sua testimonianza sotto giuramento, Satya Nadella ha riconosciuto che i chatbot hanno sottratto clic ai siti di notizie, offrendo direttamente le informazioni sulla piattaforma AI. Un ingegnere di OpenAI osservava nei messaggi interni che gli utenti non avrebbero cliccato sui collegamenti, per quanto visibili. Turley concordava sull’assenza di una buona ragione per aprirli quando la risposta era già disponibile e prevedeva che, migliorando, i chatbot sarebbero diventati sempre più sostitutivi.
Gli atti affrontano anche l’accesso ai contenuti protetti da paywall. Nadella ha dichiarato che le aziende di intelligenza artificiale non dovrebbero aggirare quelle barriere violando le condizioni d’uso dei siti. Nei messaggi interni di OpenAI citati nella richiesta, invece, il dipendente Nick Ryder informava il presidente Greg Brockman della scoperta di un espediente che consentiva ai crawler di superare il paywall del New York Times. La risposta di Brockman esprimeva apprezzamento per la scoperta.
Per documentare la riproduzione dei testi, gli editori hanno sperimentato richieste diverse a ChatGPT e Copilot. Oltre a domandare ripetutamente la riga successiva di un articolo, hanno chiesto riassunti, punti chiave e valutazioni della parzialità delle notizie. Quest’ultima modalità si è rivelata particolarmente efficace nei test descritti negli atti. In alcuni casi, anche chiedere al chatbot di scegliere un articolo dalla pagina iniziale di una testata ha prodotto porzioni dei testi originali.
La richiesta di giudizio sommario riguarda soltanto gli articoli per i quali le risposte mostrano ampie corrispondenze letterali; le contestazioni relative agli altri contenuti saranno affrontate al processo, sostengono gli editori. La loro tesi combina due elementi: la riproduzione delle opere e la capacità dei chatbot di sostituirle nel mercato di riferimento. Le dichiarazioni interne e i risultati dei test sono gli argomenti con cui intendono contrastare la difesa fondata sul fair use.
Microsoft respinge questa lettura e difende i propri prodotti come un uso trasformativo dei contenuti, sostenendo che non sostituiscano i siti di notizie. Un portavoce ha precisato che Nadella parlava dei cambiamenti generali nel modo in cui le persone trovano e consumano informazioni: quelle osservazioni, nella posizione dell’azienda, vanno distinte dalle conclusioni sulle questioni di copyright sottoposte al tribunale. È su questo terreno che si confrontano la difesa dei prodotti AI e la richiesta degli editori di tutelare gli incentivi economici alla produzione dei contenuti che li alimentano.