

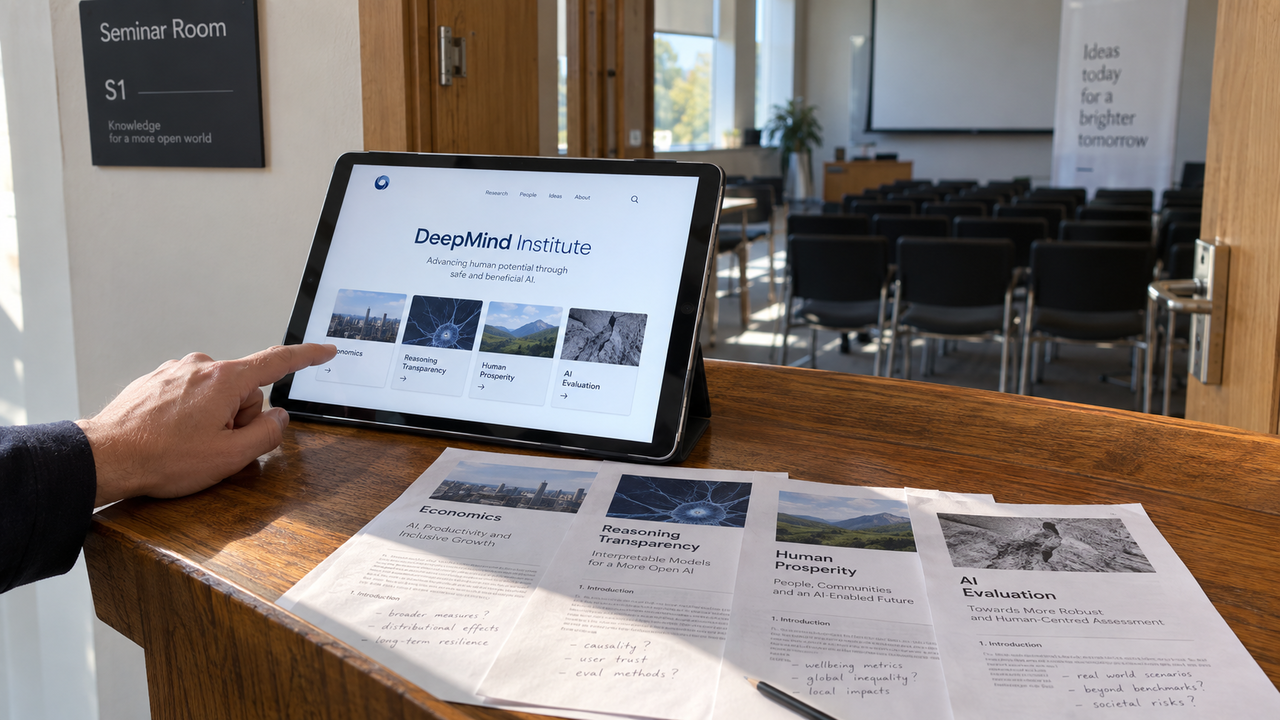
Ricercatori di Google e Google DeepMind hanno lanciato mercoledì il DeepMind Institute, un’iniziativa per ampliare il confronto sull’intelligenza artificiale generale, o AGI. Il debutto si accompagna a quattro saggi che affrontano le conseguenze economiche, la trasparenza e la valutazione dei sistemi più avanzati. L’obiettivo dichiarato è far emergere posizioni diverse all’interno di Google, di Google DeepMind e della comunità scientifica internazionale, dando spazio anche al disaccordo e alla revisione delle idee man mano che diventano disponibili nuovi dati.
Tra i direttori figurano il cofondatore di DeepMind Shane Legg, il dirigente di Google James Manyika e il presidente di Google DeepMind Demis Hassabis. Legg assume anche il ruolo di responsabile editoriale. Nell’annuncio, l’istituto chiarisce che i partecipanti non saranno sempre d’accordo e potranno cambiare opinione alla luce delle informazioni che emergono dalla ricerca di frontiera. Il progetto affida quindi a figure di primo piano dell’azienda una sede di confronto aperta a una pluralità di posizioni sull’AGI.
La raccolta inaugurale di quattro saggi delinea l’ampiezza dell’agenda: politiche economiche per gestire i possibili sconvolgimenti prodotti dall’AGI, conservazione di un ragionamento dei modelli leggibile dagli esseri umani, principi per la prosperità umana e un sistema di valutazione dell’AI di frontiera. Il programma accosta così questioni di distribuzione e gestione dell’impatto economico a problemi tecnici di controllo, fino alle condizioni con cui i sistemi più potenti potrebbero arrivare sul mercato.
Il contributo dei ricercatori di sicurezza Rohin Shah e Anca Dragan affronta la progressiva riduzione della possibilità di osservare e verificare il ragionamento di un modello, passaggio per passaggio. Secondo gli autori, questa perdita di trasparenza non è inevitabile. Le nuove architetture rendono più difficile monitorare i sistemi più potenti, ma sviluppatori e regolatori possono affrontare esplicitamente i compromessi che ne derivano per la sicurezza, anziché accettare la minore leggibilità come una conseguenza obbligata dell’evoluzione tecnologica.
Una delle opzioni proposte consiste nel limitare la «opaque serial depth», cioè la quantità di calcolo sequenziale che un modello può eseguire senza produrre una traccia di ragionamento leggibile. Un’altra è chiedere agli sviluppatori di dimostrare che i sistemi meno trasparenti restano altrettanto monitorabili. Per chi sviluppa questi modelli, la proposta sposta l’attenzione sulla possibilità di verificare concretamente il loro comportamento: anche un’architettura meno leggibile dovrebbe offrire strumenti di controllo di efficacia equivalente.
Hassabis propone invece un organismo per gli standard dell’AI di frontiera guidato dagli Stati Uniti, incaricato di valutare i modelli più avanzati. Nella fase iniziale, gli sviluppatori li sottoporrebbero volontariamente alla revisione fino a 30 giorni prima del rilascio. Una volta dimostrata l’efficacia del sistema di valutazione, il superamento dei test potrebbe diventare un requisito per distribuire questi modelli negli Stati Uniti. Il percorso delineato passerebbe dunque dalla partecipazione volontaria a una possibile condizione di accesso al mercato.
L’organismo definirebbe inizialmente le prove consultando le aziende di AI, per poi sviluppare valutazioni indipendenti e non divulgate, i cosiddetti test «held-out». Lo scopo è impedire ai laboratori di adattare i modelli a verifiche già conosciute. Hassabis contempla inoltre un rafforzamento del sistema qualora la gravità della situazione lo richiedesse, fino a un rallentamento coordinato tra gli sviluppatori dei modelli di frontiera.
I saggi si inseriscono in un dibattito sulla sicurezza che si sta spostando dalle dichiarazioni generali di preoccupazione a proposte concrete di divulgazione delle informazioni e scrutinio esterno. Nella settimana del lancio, alcuni leader del settore hanno sostenuto elementi dell’appello di Dario Amodei, amministratore delegato di Anthropic, a regolare il ritmo dello sviluppo dell’AI di frontiera. Tra le opzioni discusse entra così anche il coordinamento dei tempi di sviluppo, qualora le misure di protezione restassero indietro rispetto alle capacità dei sistemi.