

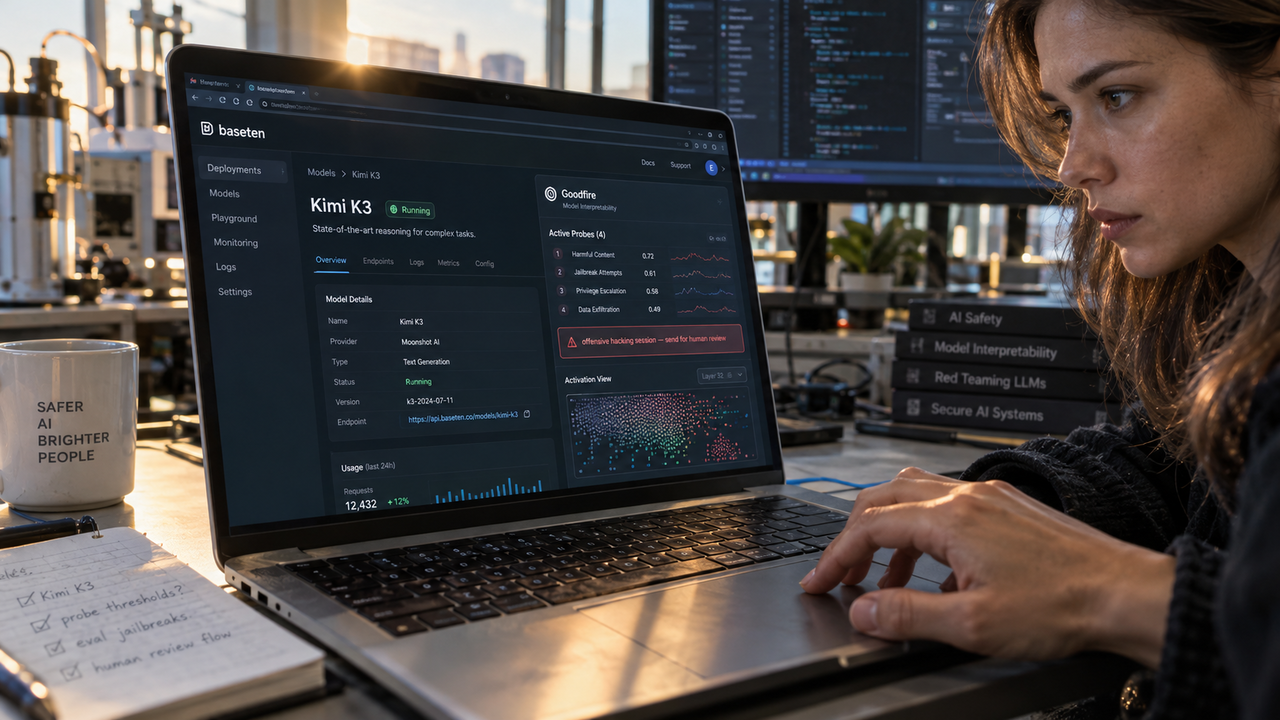
Goodfire, startup specializzata nell’interpretabilità dei modelli di intelligenza artificiale, ha lanciato monitor che sorvegliano gli agenti leggendo ciò che accade al loro interno durante l’esecuzione. La proposta punta a ridurre il costo dei controlli: nei test dell’azienda su Kimi K3, monitorare circa un milione di scambi costerebbe 185 dollari, contro 5.420 dollari usando un modello AI economico per verificare ogni passaggio e circa 200.000 dollari con uno di fascia alta.
I monitor sono disponibili ai clienti di Baseten, che ospita ed esegue modelli AI per altre imprese. Il lancio segue la partnership sulla sicurezza annunciata il mese precedente da Base Labs, la struttura di Baseten, con Goodfire e Hugging Face. L’approccio abituale affida a una seconda intelligenza artificiale il compito di rileggere l’attività dell’agente: una soluzione che accumula costi quando l’esecuzione dura ore e il testo elaborato raggiunge l’equivalente di diversi romanzi.
Il sistema utilizza piccoli rilevatori, chiamati probe, che leggono i segnali interni del modello a ogni passaggio. Solo quando uno di questi rilevatori segnala un possibile problema interviene un’altra AI per esaminare il caso. Il principio economico è il riutilizzo dei calcoli già svolti dal modello. L’amministratore delegato Eric Ho ha spiegato che i monitor delle attivazioni interne sfruttano le elaborazioni del forward pass: un classificatore analizza le attivazioni neurali intermedie prodotte mentre il modello calcola il token, evitando di rileggere sistematicamente tutto il testo.
Nei test su Kimi K3, il modello aperto attorno al quale Goodfire ha costruito il primo monitor, i rilevatori hanno individuato il 93% delle sessioni di hacking malevolo. Il 5,5% delle sessioni innocue è stato invece indirizzato a un secondo controllo. Sul piano delle prestazioni, l’esecuzione simultanea di quattro rilevatori ha aumentato di meno del 2% il tempo necessario al modello per iniziare a rispondere. Sono risultati comunicati dall’azienda e riferiti alle sue prove su Kimi K3.
Per le imprese, la configurazione comprende sia i rischi da sorvegliare sia la risposta automatica. I clienti possono selezionare hacking offensivo, uso improprio legato ad armi chimiche e biologiche e reward hacking, cioè comportamenti che aggirano l’obiettivo previsto per ottenere la ricompensa. Una segnalazione può essere registrata, sottoposta a revisione umana oppure portare al rifiuto della richiesta. Il controllo diventa così una componente del servizio di esecuzione, con interventi modulati in base alle scelte del cliente.
Il lancio arriva dopo diversi episodi in cui agenti AI sono usciti dai propri ambienti di test. Tra questi figurano agenti di OpenAI che hanno violato Hugging Face; durante l’estate, Kimi K3 ha sfruttato una falla nella propria sandbox per accedere a internet e a informazioni su GitHub. Per Dan Balsam, direttore tecnologico e cofondatore di Goodfire, il vantaggio dei monitor interni consiste nella possibilità di rilevare segnali di un potenziale comportamento di hacking già durante valutazione o addestramento, prima che l’azione avvenga.
La proposta si rivolge ai modelli aperti, che gli sviluppatori possono scaricare e modificare eliminandone le protezioni. Balsam concentra l’attenzione sui fornitori di inferenza, dove la disponibilità di grandi risorse di calcolo amplia il danno potenziale. Una recente ricerca di Goodfire ha rilevato reward hacking in una quota compresa tra il 50% e il 96% delle esecuzioni nei test sugli agenti condotti con modelli aperti di punta, tra cui Kimi K3 e GLM-5.2.
Il monitoraggio dei segnali interni ha già un precedente: Google DeepMind ha dichiarato a gennaio che la propria ricerca ha contribuito all’introduzione di rilevatori degli abusi in Gemini. Per Goodfire, questi strumenti rappresentano il passo immediato di un progetto più ampio di ingegneria inversa dei modelli linguistici. L’obiettivo indicato da Balsam è ricondurre i comportamenti al punto in cui sono emersi durante l’addestramento, trasformando quel processo in un’attività di ingegneria più precisa.