

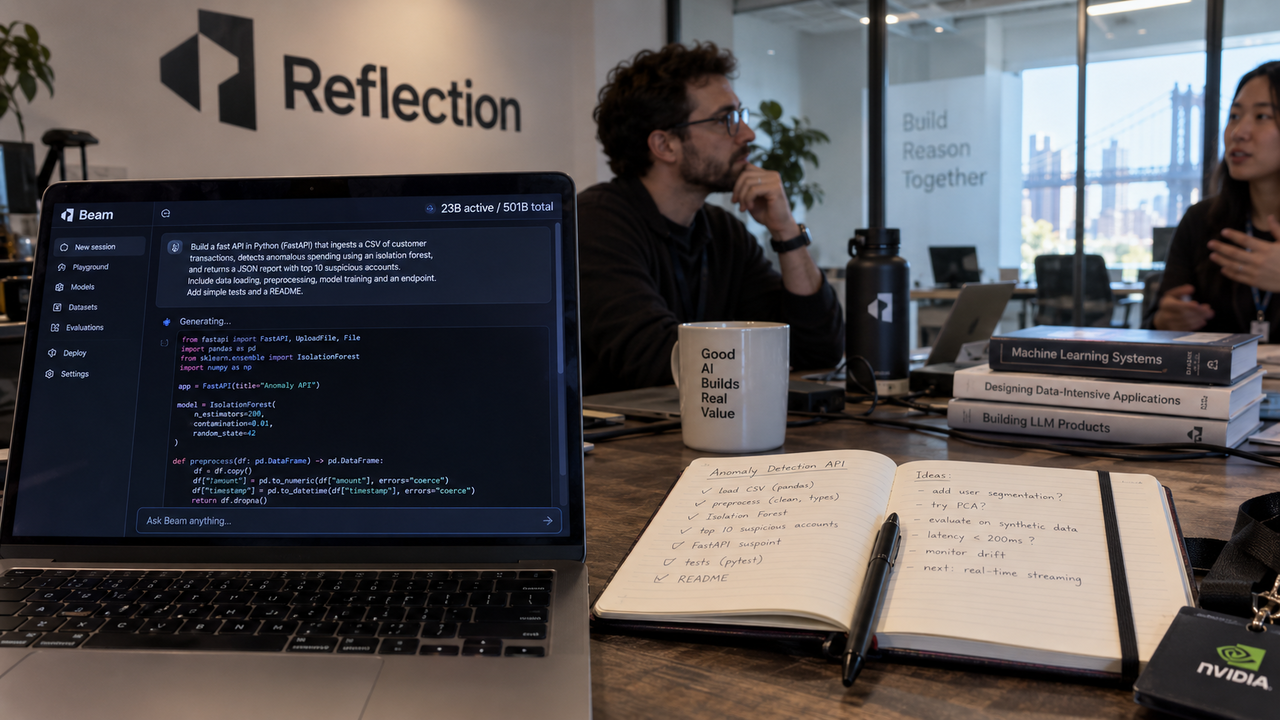
Reflection AI presenta Beam, il suo primo modello di frontiera a pesi aperti, con una promessa precisa: raggiungere le prestazioni dei principali modelli cinesi nei benchmark di ragionamento avanzato consumando meno risorse di calcolo. La startup di Brooklyn, attiva da due anni, entra così nella competizione per costruire un’alternativa occidentale a DeepSeek, Qwen e Z.ai. Il prodotto si rivolge a imprese, settore pubblico e sviluppatori, con un posizionamento che mette insieme capacità di ragionamento e contenimento dei costi operativi.
Beam elabora soltanto testo e adotta un’architettura mixture-of-experts: conta 501 miliardi di parametri complessivi, dei quali 23 miliardi attivi. Il preaddestramento ha utilizzato 23.800 miliardi di token, mentre la finestra di contesto arriva a un milione di token. Per confronto, GLM-5.2 di Z.ai dispone di circa 744 miliardi di parametri totali e 40 miliardi attivi. Reflection descrive inoltre un addestramento con apprendimento per rinforzo ad alto impiego di calcolo, orientato a ragionamento, programmazione e attività svolte da agenti.
Nei test di ragionamento avanzato, l’azienda dichiara risultati allineati a GLM-5.2 e superiori a quelli degli attuali modelli aperti occidentali di punta, utilizzando da tre a quattro volte meno calcolo in inferenza. Le prestazioni dichiarate non sono state verificate in modo indipendente. La proposta commerciale ruota quindi intorno all’esecuzione: Reflection sostiene che Beam possa affrontare questi compiti con una frazione del costo in token e delle risorse necessarie ai concorrenti durante l’inferenza, la fase in cui il modello produce le risposte.
La competizione comprende i laboratori di modelli chiusi Anthropic e OpenAI, gli sviluppatori cinesi e operatori occidentali come Mistral, Meta e Cohere. Negli Stati Uniti, il confronto più diretto potrebbe essere con Inkling, il modello aperto pubblicato a luglio da Thinking Machines Lab, la società di Mira Murati. Nei benchmark di Reflection, Beam ottiene punteggi superiori in quattro test di programmazione per i quali entrambi pubblicano risultati. I due prodotti hanno però un perimetro diverso: Inkling è multimodale, mentre Beam lavora esclusivamente sul testo.
Fondata nel 2024 da due ex ricercatori di Google DeepMind, Reflection ha raccolto circa 4,7 miliardi di dollari, con investitori che includono NVIDIA, Sequoia Capital e Lightspeed Venture Partners. L’ultimo round ha attribuito alla società una valutazione pre-money di 25 miliardi di dollari. Il lancio arriva dunque dopo una raccolta di capitali consistente, destinata a sostenere lo sviluppo di modelli capaci di attrarre clienti sia dai sistemi proprietari dei grandi laboratori sia dalle alternative cinesi a pesi aperti e meno costose.
Alla disponibilità finanziaria si affianca quella delle infrastrutture. Durante l’estate Reflection ha firmato accordi con SpaceX e Nebius dal valore complessivo superiore a 7 miliardi di dollari, per assicurarsi accesso ai chip NVIDIA GB300 fino al 2029. La capacità di calcolo sostiene l’addestramento dei modelli di frontiera e accompagna l’ambizione della startup di competere su prestazioni e costi. Gli accordi coprono quindi un orizzonte che va oltre il debutto di Beam e riguarda anche lo sviluppo dei prodotti successivi.
Per imprese e Stati, Reflection propone le AI factories: sistemi locali personalizzati attraverso l’addestramento dei suoi modelli sui dati proprietari delle istituzioni clienti. L’obiettivo è consentire a queste organizzazioni di costruire una propria infrastruttura di intelligenza artificiale. È una visione sostenuta da tempo anche da Jensen Huang, amministratore delegato di NVIDIA, che finanzia Reflection e promuove il rafforzamento dell’ecosistema AI aperto. Le GPU dell’azienda alimenterebbero questi sistemi, collegando la diffusione dei modelli alla domanda di hardware.
Reflection ha già iniziato a sperimentare una partnership per una AI factory sovrana con Shinsegae Group, in Corea del Sud. Per Beam, l’azienda prevede di pubblicare pesi e dettagli tecnici completi nel corso di ottobre. La distribuzione passerà attraverso hyperscaler e neocloud, con integrazioni nelle librerie open source disponibili al lancio. Questi canali costituiscono il passaggio operativo tra la presentazione del modello e il suo impiego da parte di sviluppatori e organizzazioni, mentre la sperimentazione sudcoreana avvia il progetto dei sistemi locali personalizzati.