

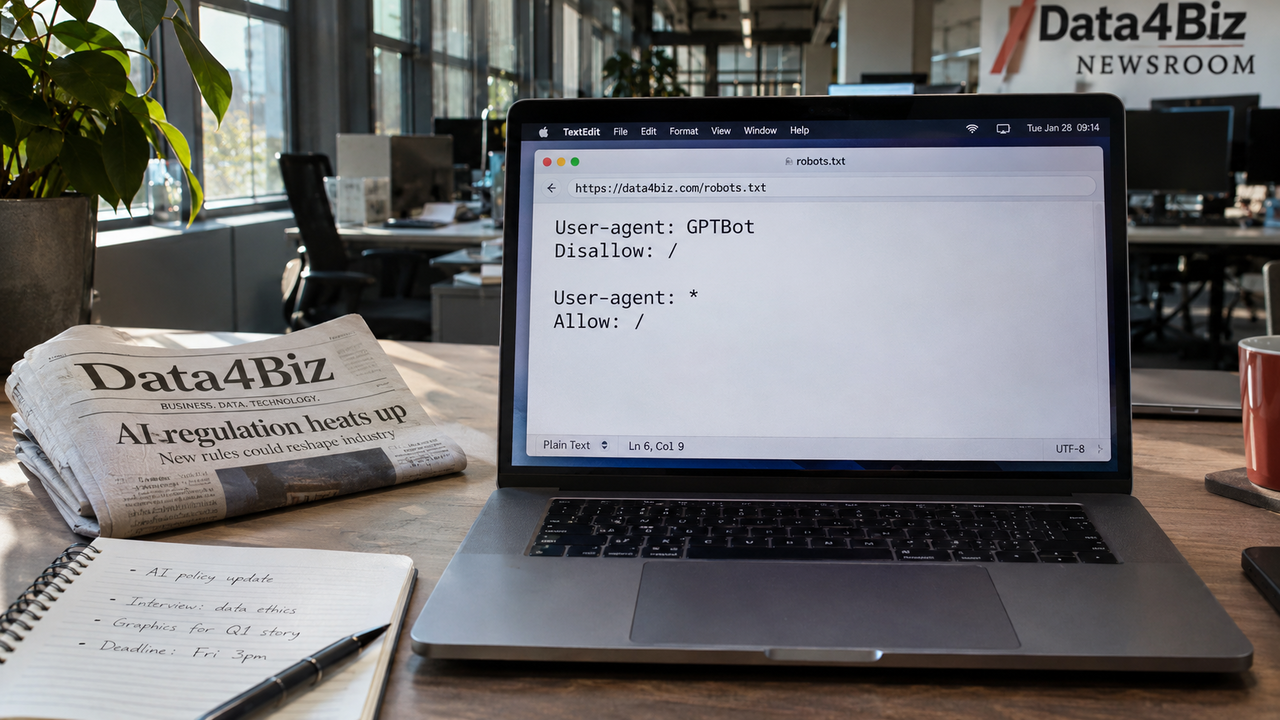
OpenAI, Google, Microsoft e Anthropic sostengono un nuovo segnale condiviso che permette ai proprietari dei siti web di indicare se i loro contenuti possono essere utilizzati per addestrare modelli di intelligenza artificiale. Il meccanismo introduce una modalità comune di opt-out: la preferenza viene espressa nel file che fornisce istruzioni ai bot in visita sul sito. Per editori e imprese, è uno strumento per comunicare come intendono consentire l'utilizzo del proprio patrimonio informativo.
Il punto di intervento è robots.txt, un file di testo collocato nella directory principale del sito. La sua funzione è fornire indicazioni sul comportamento dei crawler, i programmi che esplorano automaticamente le pagine web. Può offrire una mappa ai sistemi dei motori di ricerca e contribuire a evitare che le richieste automatiche sovraccarichino i server. Il segnale dedicato all'addestramento aggiunge a queste istruzioni una scelta specifica sull'impiego dei contenuti da parte dei fornitori di AI.
OpenAI ha invitato anche gli altri operatori ad aderire: «Incoraggiamo altri fornitori di AI a rispettare il segnale». La questione nasce dalla raccolta ripetuta di pagine e informazioni con cui le aziende costruiscono archivi di dati di addestramento e sviluppano le capacità dei modelli. A questo processo si affiancano i cambiamenti nella ricerca online e nelle abitudini di accesso alle informazioni: i contenuti pubblicati su un sito possono alimentare risposte consultate attraverso servizi diversi da quello che li ha prodotti.
Un'altra strada è subordinare la consultazione dei contenuti alla creazione di un account, secondo l'approccio pianificato da Reddit per bloccare il traffico AI. La registrazione introduce un passaggio di identificazione: gli account richiedono normalmente una verifica attraverso un indirizzo email o un numero di telefono, utile a distinguere gli utenti dai visitatori automatizzati. L'accesso libero offre invece un percorso immediato a chi arriva dal web e cerca una risposta, senza richiedere la consegna di informazioni personali a un ulteriore servizio. La scelta coinvolge quindi anche il rapporto tra sito e pubblico.
Il controllo può inoltre concentrarsi sulla frequenza delle richieste provenienti da un singolo indirizzo IP. Alcuni servizi di terze parti permettono di impostare intervalli e soglie per gestire il traffico riconosciuto come automatizzato, con un possibile costo economico per il gestore. Un esempio è consentire soltanto 5 richieste nell'arco di 10 secondi dallo stesso indirizzo. In questo caso il filtro interviene sul ritmo degli accessi, offrendo un modo per contenere le raffiche di connessioni che possono gravare sull'infrastruttura del sito.
I CAPTCHA aggiungono invece una verifica di umanità al percorso di navigazione. Possono filtrare tentativi insistenti degli scraper e bot AI meno capaci, affiancando i controlli sugli accessi e le istruzioni rivolte ai crawler. Le diverse misure agiscono così su aspetti distinti: la destinazione d'uso dei contenuti, l'identificazione del visitatore, il volume delle richieste e la verifica dell'interazione umana. La difesa su più livelli combina questi strumenti per gestire la raccolta automatizzata, anziché affidare l'intero controllo a un unico meccanismo.
L'efficacia dipende però dal rispetto delle istruzioni da parte dei bot, mentre gli IP a rotazione aggirano i blocchi sul singolo indirizzo, alcuni modelli risolvono i CAPTCHA e gli obblighi di registrazione o le verifiche possono spingere i visitatori ad abbandonare il sito. Per le imprese, la scelta degli strumenti coinvolge dunque gestione tecnica, costi dei servizi e esperienza degli utenti: la protezione dei contenuti passa anche dalle condizioni alle quali il pubblico può consultarli.