

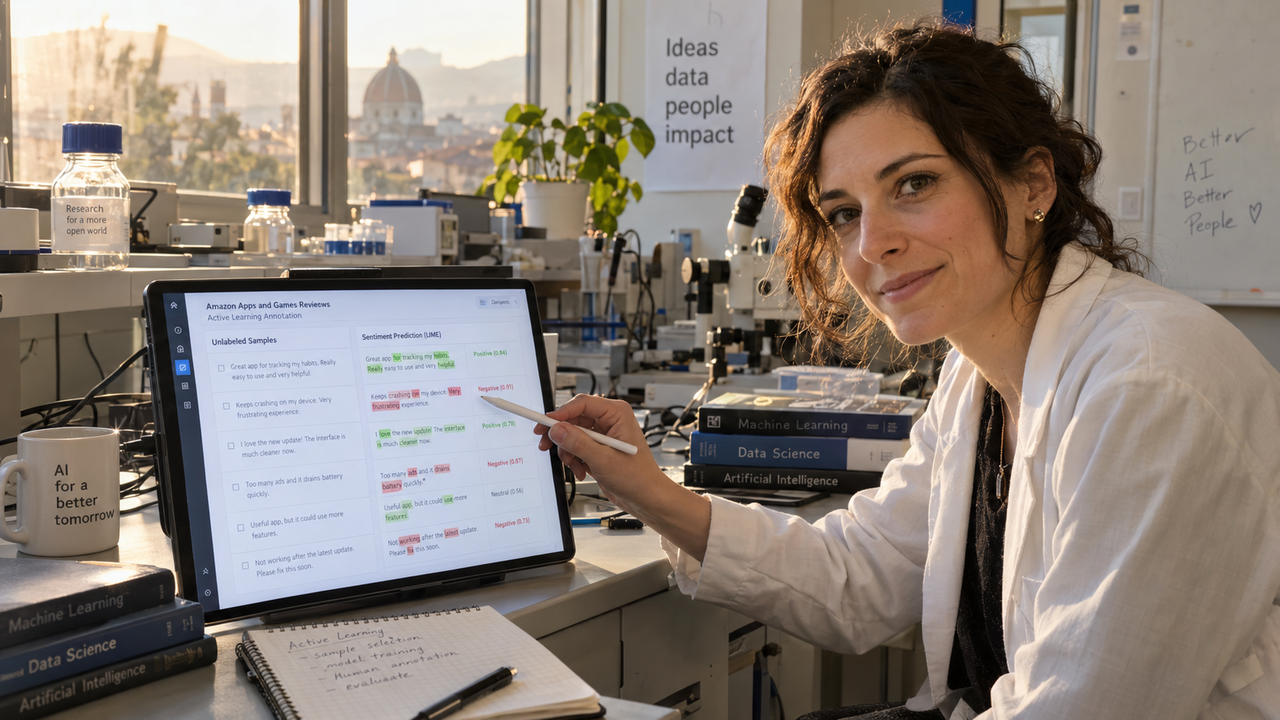
Due agenti di intelligenza artificiale, con compiti distinti, per migliorare l’analisi delle opinioni dei consumatori e rendere più efficiente la preparazione dei dati. Un gruppo di ricercatori propone un modello di sentiment analysis che raggiunge una F-measure del 95,580% sul dataset Amazon Apps and Games Reviews. Il progetto affronta insieme diversi ostacoli di questi sistemi: il costo dell’annotazione, la scelta delle caratteristiche informative, lo squilibrio fra le classi e la capacità di generalizzare.
La valutazione comprende altri due dataset: Amazon Instant Video, sul quale il modello ottiene il 95,163%, e Yelp, dove raggiunge il 93,054%. I test utilizzano una validazione incrociata in cinque parti e mostrano risultati superiori ai sistemi di confronto tradizionali e basati su transformer. Le analisi statistiche indicano miglioramenti significativi, con p < 0,01. Si tratta di risultati di classificazione sperimentale: non misurano direttamente un aumento delle vendite o del rendimento delle campagne pubblicitarie.
L’architettura combina due agenti attraverso un framework di apprendimento per rinforzo chiamato off-policy PPO, una variante della proximal policy optimization. Il primo agente si occupa di active learning: seleziona, fra i campioni ancora privi di etichetta, quelli più informativi da sottoporre ad annotazione. Il secondo esegue l’analisi del sentiment. La selezione iniziale serve a ridurre i costi di etichettatura, concentrando il lavoro sui dati che possono contribuire maggiormente all’apprendimento del classificatore.
All’interno del secondo agente, la scelta delle caratteristiche è guidata da LIME, un metodo che spiega le previsioni di un modello complesso attraverso un’approssimazione più semplice. L’analisi riguarda il singolo campione e il suo intorno, invece dell’intero comportamento del classificatore. Il sistema crea piccole variazioni dell’esempio originale, osserva le risposte del modello e assegna maggiore peso alle variazioni più vicine. Da questo processo emergono le caratteristiche che influenzano maggiormente quella specifica previsione.
I coefficienti dell’approssimazione locale indicano anche la direzione del contributo: un valore positivo aumenta la previsione, uno negativo la riduce. Nel framework, queste informazioni diventano punteggi di importanza locale e vengono integrate nel meccanismo di ricompensa che orienta l’apprendimento. LIME viene costruito dinamicamente attorno a ciascun esempio, senza un ulteriore addestramento globale. La spiegazione della previsione assume così una funzione operativa nella selezione delle caratteristiche, oltre a renderne interpretabile il peso sul risultato.
Per riconoscere meglio le classi sottorappresentate, il secondo agente utilizza ricompense potenziate. La varietà dei dati viene invece ampliata durante l’apprendimento attraverso RelGANGE, un framework basato su una rete generativa avversaria relazionale con esclusione dei segnali di gradiente. Il generatore ignora i gradienti provenienti dai campioni ai quali il discriminatore attribuisce pesi elevati. Questo accorgimento punta ad aumentare la diversità dei campioni generati, affiancando l’ampliamento dei dati agli interventi sul riconoscimento delle categorie meno rappresentate.
Anche la regolazione degli iperparametri rientra nel processo: i ricercatori utilizzano BOHB, che combina ottimizzazione bayesiana e Hyperband. Il disegno riunisce quindi selezione dei campioni, spiegazioni locali, ricompense, generazione di dati e ottimizzazione delle impostazioni in un unico flusso di apprendimento. Gli autori presentano questa integrazione come la differenza rispetto agli approcci che affrontano separatamente i problemi di annotazione, selezione delle caratteristiche, squilibrio delle classi e generalizzazione.
Le applicazioni indicate dai ricercatori comprendono i sistemi di raccomandazione per l’e-commerce e gli strumenti di supporto alle decisioni. Per il marketing digitale, il punto di partenza è la relazione fra sentiment dei consumatori, percezione del marchio e decisioni di acquisto. Il modello propone di intervenire sulla qualità del processo che trasforma le opinioni in informazioni utilizzabili: scegliere quali esempi annotare, individuare gli elementi che guidano la classificazione e migliorare il riconoscimento delle classi meno rappresentate.