

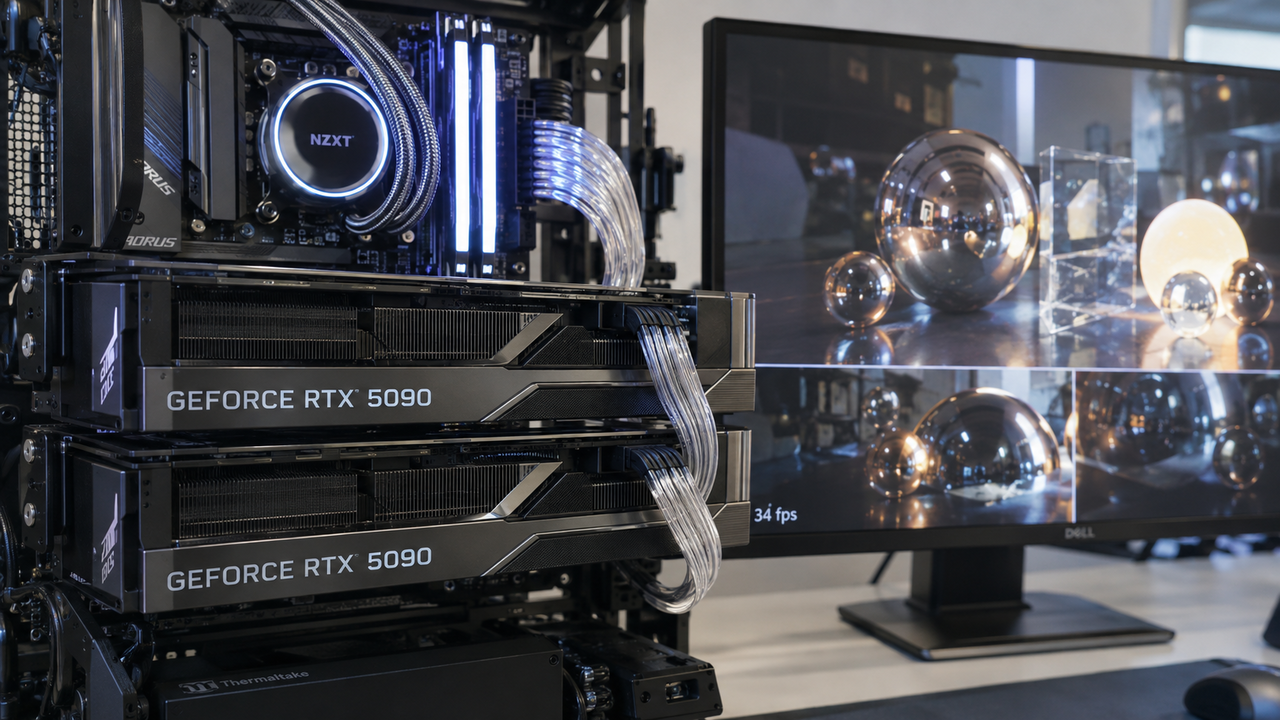
Un prompt e circa un’ora di lavoro: è quanto è bastato a uno sviluppatore per ottenere con Claude Opus 5.5 un path tracer 3D accelerato dall’hardware e capace di funzionare in tempo reale. La richiesta chiedeva una demo di ray tracing basata su CUDA, RTX e kernel Blackwell, in grado di usare entrambe le schede NVIDIA RTX 5090 dell’utente. Doveva inoltre mostrare materiali e fenomeni diversi, dalla diffusione della luce alle superfici metalliche, fino a riflessi, trasparenza, traslucenza e autoilluminazione.
La dimostrazione è stata condivisa su Reddit dall’utente Zealousideal_View_12. Claude ha scritto una base di codice in C++ e CUDA e ha utilizzato NVIDIA OptiX 9.1 per accedere alle capacità dedicate delle GPU, compresi RT core e Tensor core. Il caso mostra come un assistente AI possa assemblare un progetto grafico funzionante anche quando chi lo guida non padroneggia nel dettaglio API grafiche, compilazione degli shader ed esecuzione parallela.
Il motore distribuisce il lavoro sulle due schede attraverso una pipeline multiadattatore che divide orizzontalmente ogni fotogramma. Le righe da elaborare vengono assegnate alle GPU con un bilanciamento del carico in tempo reale, invece di affidare a ciascuna scheda un fotogramma completo alla volta. È una scelta che porta la gestione del lavoro parallelo dentro il ciclo di rendering: per produrre l’immagine, le due GPU devono svolgere le rispettive porzioni del calcolo e i risultati devono poi essere coordinati.
Questo coordinamento comporta trasferimenti di memoria tra host e dispositivi, indicati come operazioni H2D e D2H. Nonostante tale costo, la demo raggiunge 34 fotogrammi al secondo ed elabora 267 milioni di campioni di raggi al secondo. I numeri descrivono il funzionamento della configurazione mostrata, con due RTX 5090, e danno una misura concreta del risultato ottenuto nel tempo di sviluppo dichiarato.
Nel codice compare anche Shader Execution Reordering, una tecnica NVIDIA che riorganizza dinamicamente i percorsi dei raggi sulla GPU. Serve a contenere gli arresti della pipeline quando la scena richiede riflessioni complesse. Claude non si è quindi limitato a predisporre una finestra con un’immagine: ha inserito nel motore una tecnica pensata per rendere più efficiente l’esecuzione di un carico di rendering irregolare.
Per l’illuminazione, la pipeline combina Next-Event Estimation e Multiple Importance Sampling. Le due tecniche sono impiegate per calcolare la distribuzione fisica della luce e le ombre morbide. Insieme alla gestione di materiali con proprietà differenti, spiegano l’ampiezza della richiesta iniziale: la demo doveva rappresentare effetti visivi diversi all’interno di un unico motore, mantenendo l’elaborazione in tempo reale.
Nella discussione su Reddit, un altro utente ha chiesto perché partire da zero anziché usare uno dei renderer open source già disponibili. L’autore della demo ha citato i kernel specifici per l’hardware e le ottimizzazioni come parte della risposta. Ha anche osservato che far lavorare Claude su un progetto esistente, con una grande quantità di codice e regole di compilazione rigide, avrebbe potuto aumentare il consumo di token e il rischio di errori nelle dipendenze.
La scelta di generare un progetto pulito ha così ristretto il perimetro affidato all’assistente e ha prodotto un risultato utilizzabile in 60 minuti. L’esperimento si aggiunge ad altri impieghi di Claude citati per la progettazione di un robot quadrupede, del relativo firmware e di circuiti stampati. Qui l’elemento distintivo è la combinazione, in una sola demo, di codice generato dall’AI, tecniche di rendering avanzate e ripartizione del lavoro su due GPU.